Redes Kolmogorov-Arnold cuánticas para etiquetado de jets de quark top
Un resumen técnico del proyecto QKAN, Google Summer of Code 2026 en ML4SCI
Este proyecto fue desarrollado por Jorge Toral y puede encontrarse en este repositorio de GitHub.
1. El problema y la idea central
En el Gran Colisionador de Hadrones, un quark top se desintegra casi instantáneamente y produce un jet (un chorro de partículas colimado) con una subestructura interna característica, distinta de la de un jet ordinario originado por un quark ligero o un gluon (QCD). Distinguir estos dos tipos de jet, tarea conocida como top tagging, es un problema de clasificación binaria bien estudiado, con arquitecturas clásicas de referencia que alcanzan AUCs superiores a 0.96-0.98 en el dataset público usado en este proyecto (Kasieczka et al., 2019): jets simulados a 14 TeV con Pythia8 y una tarjeta de detector Delphes tipo ATLAS, reconstruidos con anti-$k_T$ y $R=0.8$ en el rango $p_T \in [550, 650]$ GeV.
El objetivo del proyecto es responder una pregunta distinta a la de superar esas arquitecturas: ¿puede una red neuronal cuántica variacional (VQC) hacer esta tarea, y qué papel puede jugar una red clásica en hacerla viable?
La limitación de fondo es el costo de simular un circuito cuántico, que crece como $O(2^Q)$ con el número de qubits $Q$. Alimentar directamente un jet con docenas de variables a un VQC es impráctico. La solución explorada usa una red Kolmogorov-Arnold (KAN) clásica como preprocesador y filtro de qubits: se entrena, se poda hasta una topología pequeña e interpretable, y esa topología podada determina cuántos qubits necesita el circuito cuántico y cómo se conectan. De este modo, el modelo clásico fija el recurso cuántico de forma sistemática, sin recurrir a prueba y error.
El flujo completo, documentado en tres notebooks (EDA_top.ipynb, Training_process.ipynb, Analysis_of_results.ipynb), preprocesa los jets en réplicas balanceadas, entrena y poda la KAN, extrae cada arista sobreviviente a una base compacta (Chebyshev o seno) como warm start, afina la QKAN en simuladores ideal, con ruido por disparos finitos (shots) y con ruido de hardware, y compara todo contra un Random Forest clásico.
2. Motivación de la arquitectura KAN
Las redes Kolmogorov-Arnold, propuestas por Liu et al. (2024) a partir del teorema de representación de Kolmogorov-Arnold (KAT), invierten el diseño de un perceptrón multicapa (MLP) tradicional. En un MLP, las funciones de activación son fijas (ReLU, tanh, …) y viven en los nodos; los pesos aprendibles son escalares en las aristas. En una KAN la relación se invierte: cada arista lleva su propia función univariada aprendible, parametrizada como un spline, y los nodos únicamente suman. El teorema KAT garantiza que cualquier función continua multivariada puede escribirse como
\[f(x_1, \dots, x_n) = \sum_{q=1}^{2n+1} \Phi_q\left(\sum_{p=1}^{n} \phi_{q,p}(x_p)\right)\]es decir, como una composición de funciones univariadas y sumas. De aquí se derivan dos propiedades que este proyecto explota directamente. La primera es la interpretabilidad: al terminar el entrenamiento, cada arista puede ajustarse simbólicamente contra una librería de funciones candidatas, lo que da una fórmula cerrada para la transformación que realiza. La segunda, crucial para este proyecto, es la podabilidad estructurada: como cada arista es una unidad funcional independiente, se le puede medir una atribución (cuánto contribuye a la salida) y eliminarla si es despreciable, sin romper la interpretación del resto de la red.
Un trabajo posterior de los mismos autores, KAN 2.0 (Liu et al., 2024), introduce además los nodos de multiplicación. El teorema KAT en su forma clásica solo garantiza composición mediante sumas; permitir que algunos nodos ocultos multipliquen sus entradas expresa las interacciones entre variables de forma directa. La arquitectura clásica de este proyecto (HEPKAN, una subclase de pykan) adopta esta idea y usa una capa oculta con nodos de suma y de multiplicación en paralelo.
3. Exploración de los datos: qué distingue a un jet de top
Antes del entrenamiento, el notebook de EDA caracteriza el dataset. El archivo HDF5 no documenta el orden de sus columnas, por lo que se infirió a partir de los datos: cada bloque de cuatro columnas corresponde a una partícula constituyente del jet, con la energía en la primera posición y las tres componentes de momento después. El patrón se reconoce en las medias de columna, mucho mayores en la primera columna de cada bloque de cuatro.
De los histogramas y perfiles radiales surgieron cuatro observaciones que guiaron el diseño posterior:
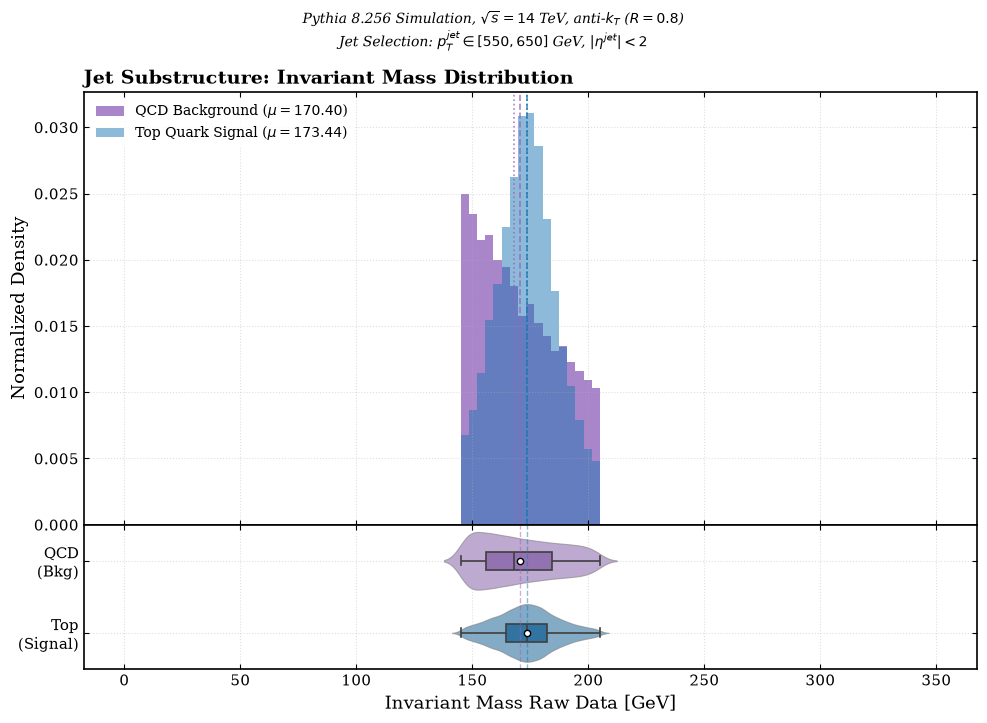
- La masa invariante discrimina, pero no basta. $m_{jet} = \sqrt{E^2 - p_x^2 - p_y^2 - p_z^2}$ tiene un pico claro en la señal alrededor de la masa del quark top (~173 GeV), mientras que el fondo es más ancho. Las dos distribuciones se solapan por secciones, así que se seleccionó la ventana 145-205 GeV para todos los experimentos: dentro de ella, la pista trivial de la masa queda en buena medida removida y los clasificadores deben apoyarse en información más sutil.
- Los jets de top son más poblados: la multiplicidad (número de constituyentes) es sistemáticamente mayor y más dispersa que en QCD, consistente con una desintegración en tres cuerpos, para este intervalo seleccionado de masa.
- Los jets de top son más difusos: el perfil radial de energía y la fracción acumulada de $p_T$ crecen más gradualmente en tops que en QCD, donde la energía está más concentrada cerca del eje del jet.
- Los diagramas de dispersión $\eta$-$\phi$ no fueron concluyentes por ruido y escala.
También se detectó un artefacto: la distribución de $\Delta R$ no muestra el corte nítido en 0.8 esperado, debido a una constante pequeña añadida para evitar división por cero. Para corregirlo se filtraron los constituyentes fuera del radio del jet.
A partir de esto se construyó la representación de entrada, que combina variables globales (masa del jet y multiplicidad, contando solo constituyentes con energía por encima de $10^{-8}$) con variables locales por cada constituyente retenido ($\Delta R$ al eje del jet y $p_{T,\text{rel}}$). Con el criterio del 80% de la distribución acumulada de $p_T$, se estimó que unos 15 constituyentes bastarían para capturar la mayor parte de la energía. La canalización final usa solo los 10 constituyentes más energéticos de cada jet, para un total de 22 entradas (2 globales + 10 pares de variables locales). Cada jet original trae hasta 200 constituyentes almacenados; el corte a 10 es una decisión deliberada de compresión que se retoma en resultados y conclusiones, ya que el modelo nunca ve el 95% de las partículas registradas por el detector.
Las variables locales ya viven en $(0,1)$. A las globales se les aplica una transformación logarítmica seguida de normalización tanh, conservando deliberadamente los valores atípicos: los centros de las dos distribuciones de clase son similares y la información discriminante está en las colas.
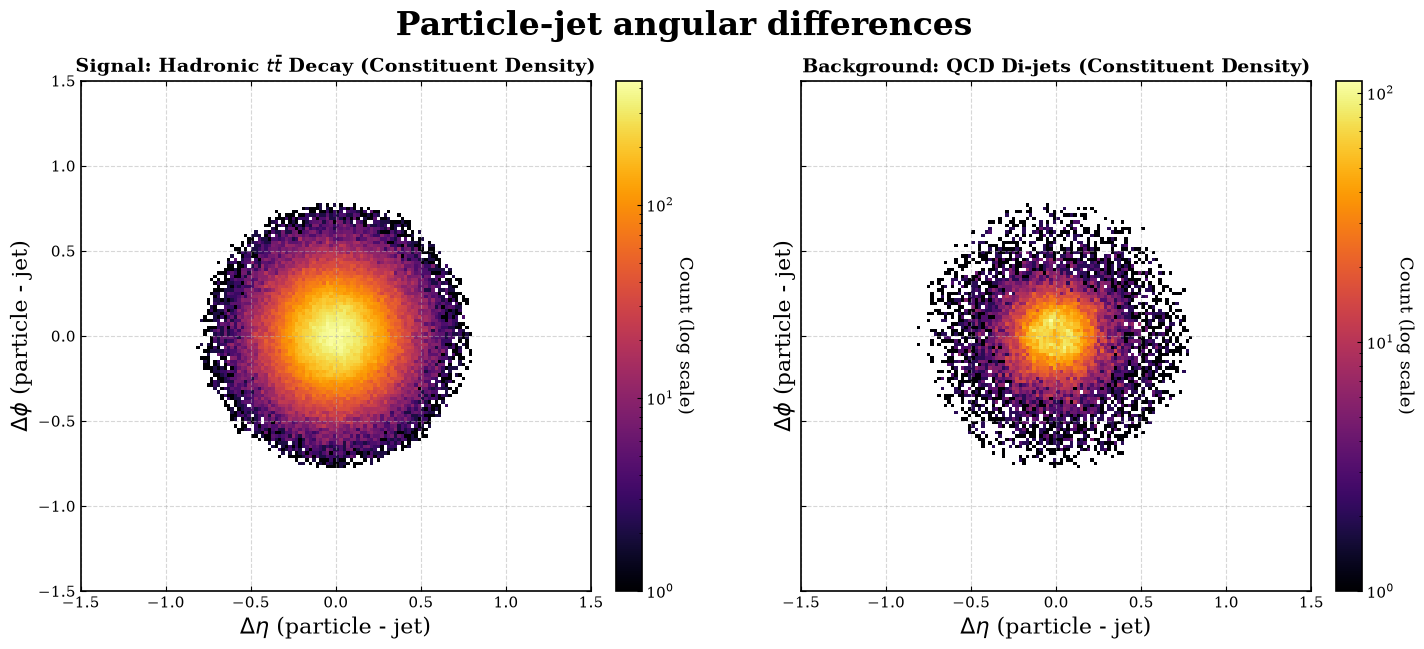
Finalmente, como el número de eventos en la ventana de masa difiere entre clases (hay más tops), se submuestrea la clase mayoritaria para balancear y el resultado se divide en 5 subconjuntos disjuntos y balanceados por clase. Cada semilla selecciona uno (seed % 5), de modo que varias semillas producen réplicas independientes de principio a fin en lugar de una única estimación puntual.
4. La arquitectura clásica y su poda
El modelo clásico tiene arquitectura [22, [9, 9], 1]: 22 entradas, una capa oculta con hasta 9 nodos de suma y 9 de multiplicación en paralelo, y una salida escalar. Los splines B usan grado $k=3$ y tamaño de malla (grid) 5, para un total de 8,568 parámetros. En la corrida de referencia (seed 10), el modelo base alcanzó un AUC de prueba de 0.792 en la evaluación puntual reportada en el notebook, consistente con la media de 0.789 ± 0.002 obtenida al agregar las cinco réplicas (sección 8). El entrenamiento se detuvo temprano, alrededor de la época 20 de las 60 planeadas.
HEPKAN introduce tres modificaciones prácticas sobre pykan, motivadas por los recursos computacionales limitados del proyecto: una corrección de un error en prune_input (pasaba un módulo en vez de un nombre de cadena al reconstruir el modelo podado, lo que rompía la serialización de checkpoints), una rutina de graficado que reutiliza una sola figura de Matplotlib para todas las aristas y omite las ya podadas, y un registro de historial no-op que evita escribir un checkpoint en cada mutación del modelo durante la poda y la búsqueda simbólica.
La poda combina un umbral de entrada de 0.01 con umbrales de atribución de 0.04 (nodos) y 0.06 (aristas), y añade una restricción dura pensada para el límite cuántico: un tope de fan-in de dos, que conserva solo las dos aristas de entrada más fuertes por neurona oculta. Tras la poda, la estructura se reentrena durante 20 épocas; en la corrida de referencia (semilla 10), el AUC de validación sube de 0.714 a ~0.755.
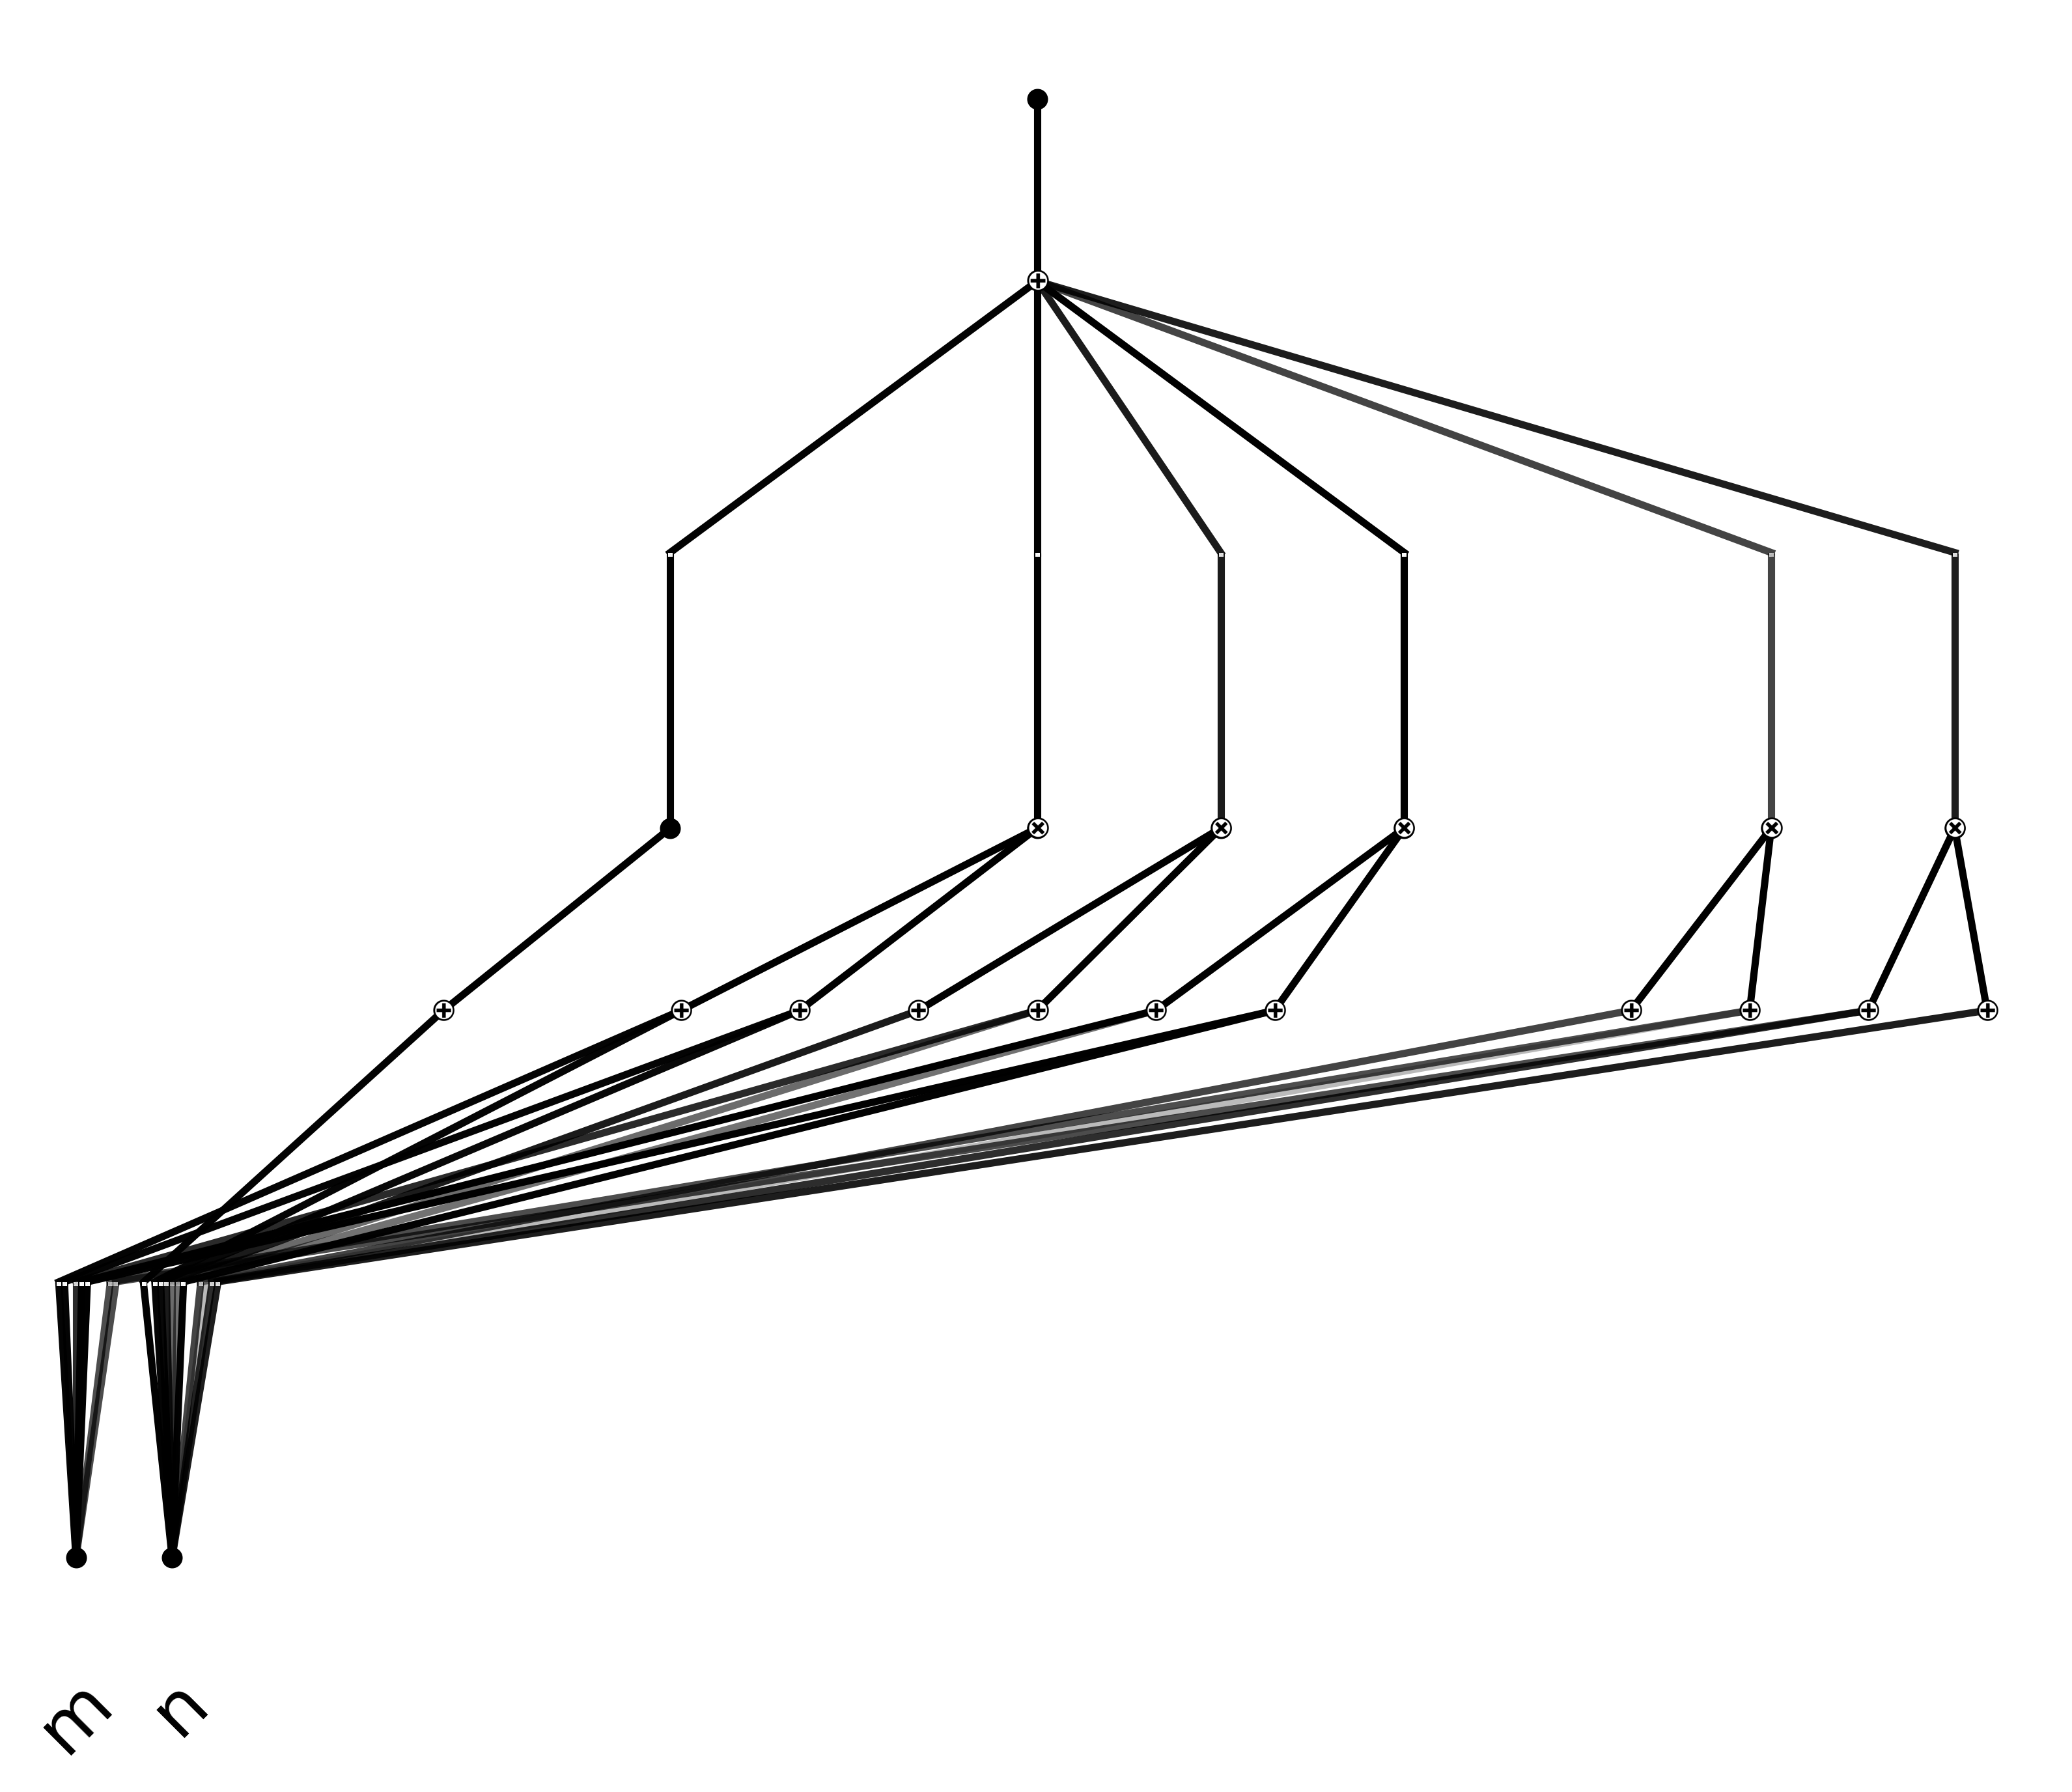
El resultado para la corrida de referencia es muy compacto: de 22 variables de entrada sobreviven solo 2 (masa del jet y multiplicidad), organizadas en 1 nodo de suma y 5 nodos de multiplicación. Este hallazgo coincide con la importancia de variables (MDI/Gini) del Random Forest de referencia (sección 7), que de forma independiente también señala a la masa y la multiplicidad como las variables con mayor peso de predicción entre las 22 disponibles. Esta confirmación cruzada indica que la poda agresiva conserva la señal relevante. El patrón se repite en las cinco semillas: siempre sobreviven la masa y la multiplicidad, con 10 u 11 qubits según la semilla (en las semillas 11 y 12 no sobrevive ningún nodo de suma).
El notebook también ejecuta un ajuste simbólico sobre cada arista sobreviviente, emparejándola contra una librería de funciones candidatas para obtener una interpretación en forma de fórmula. Esta es la principal ventaja de interpretabilidad de las KANs y forma parte de la rama puramente clásica del proyecto. La rama cuántica utiliza la respuesta numérica de cada arista en lugar de la fórmula simbólica.
5. Del grafo clásico al circuito cuántico
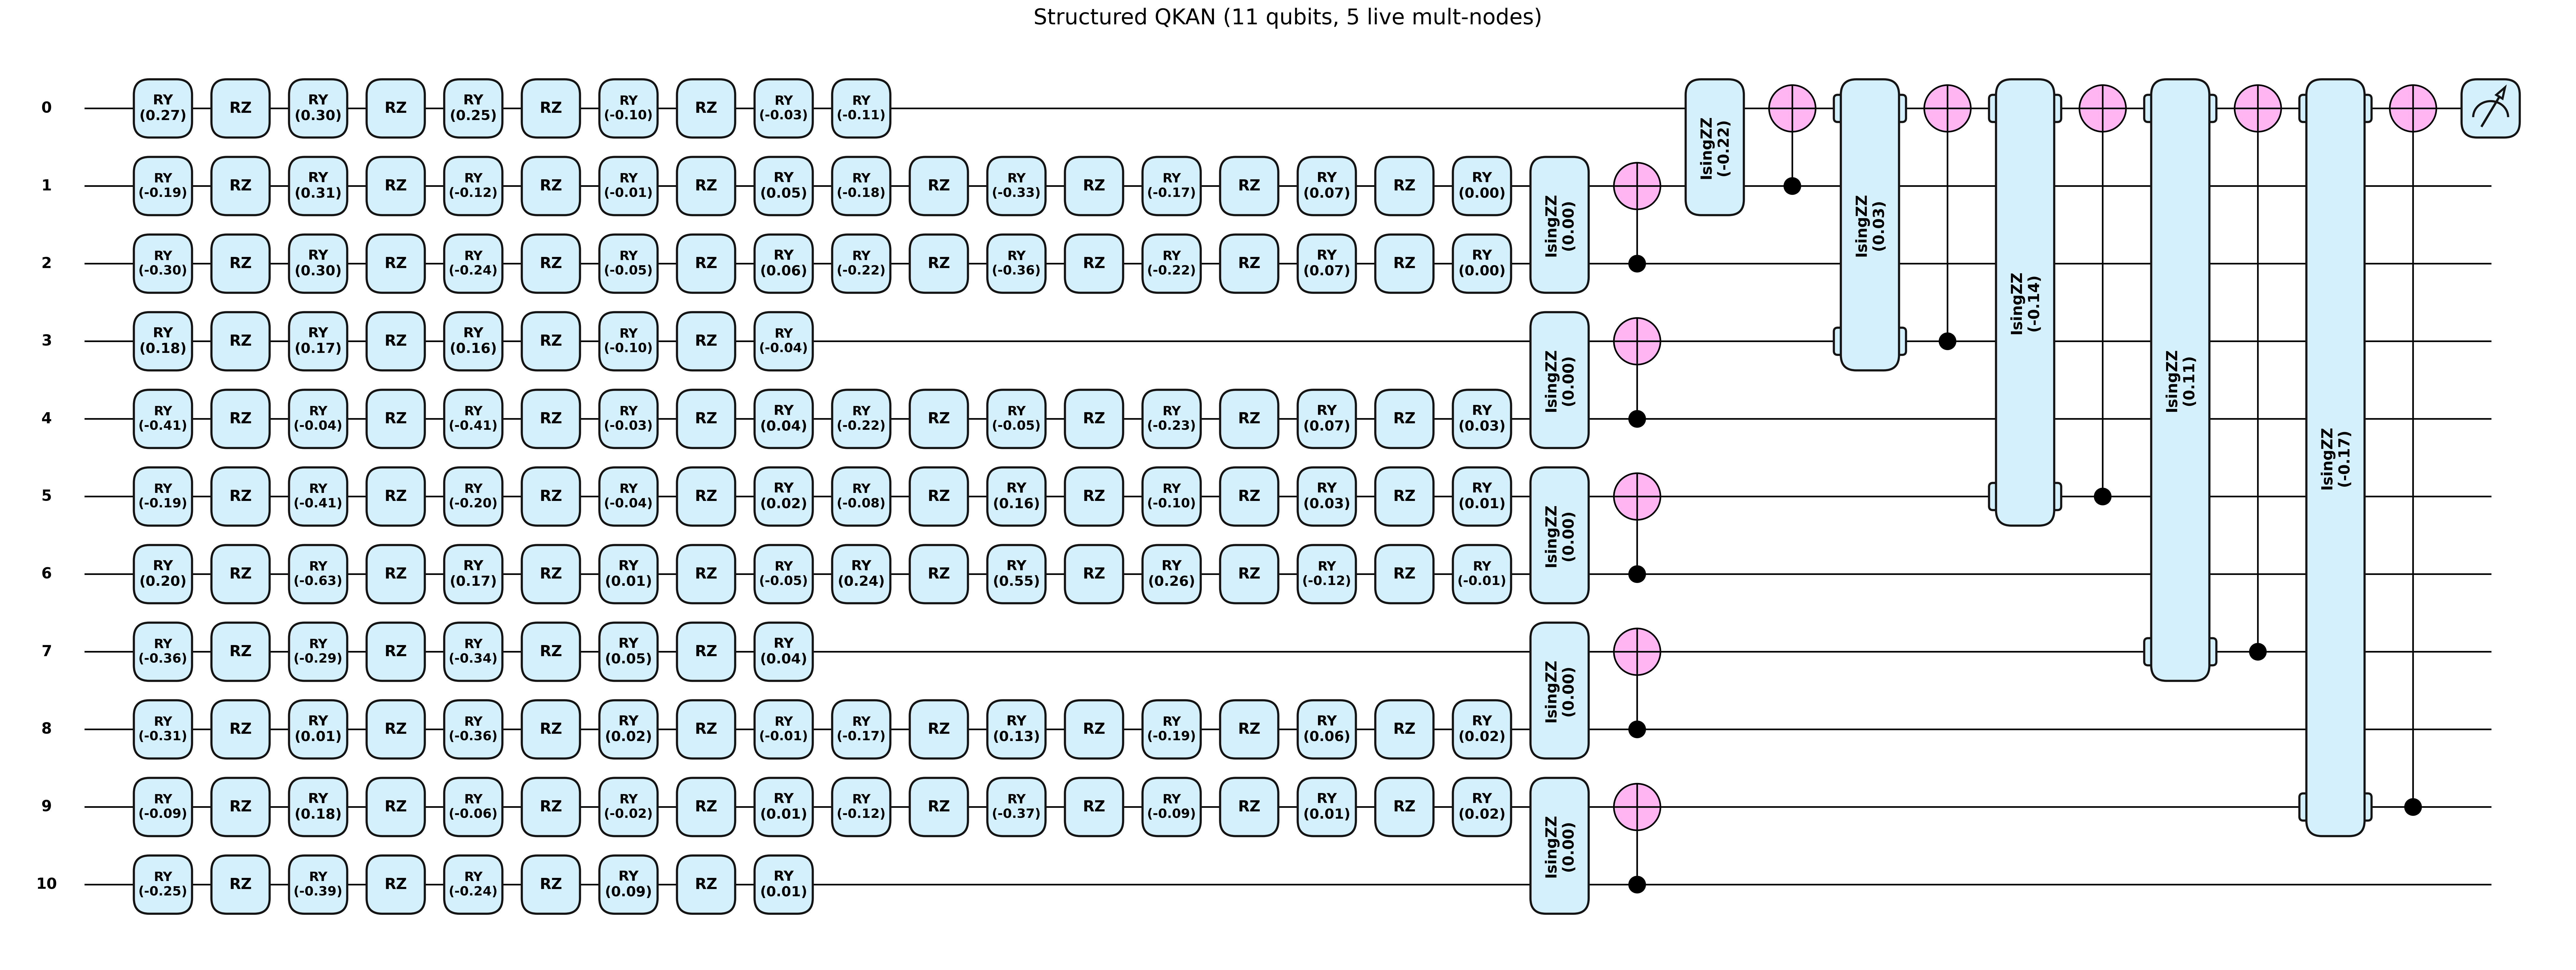
Un extractor aísla la respuesta de cada arista activa desconectando las otras entradas de su nodo destino, y exporta un grafo serializado de nodos de suma y multiplicación. Para la corrida de referencia, ese grafo tiene 11 qubits, 18 aristas de entrada, 5 transferencias IsingZZ y 6 aristas de salida, resultado directo de comprimir 22 variables a 2 entradas sobrevivientes repartidas en 1 nodo de suma y 5 nodos de multiplicación. Los qubits se cuentan por nodo acumulador sobreviviente: la misma variable de entrada puede recargarse (re-uploading) en varios cables si alimenta a varios nodos ocultos distintos. Por eso 2 variables ocupan 11 qubits.
El circuito sigue cinco principios de diseño:
- Data re-uploading: la función univariada de cada arista se modela mediante rotaciones $R_y$/$R_z$ repetidas del dato de entrada, parametrizadas por los coeficientes ajustados en el warm start, en lugar de codificar el dato una sola vez.
- Topología heredada: la capa oculta clásica decide qué variables importan y cuántos qubits se usan; el circuito reproduce la topología del grafo podado.
- Suma: cada arista que alimenta de un nodo de suma encadena compuertas de rotación $R_Y$ y $R_Z$ consecutivas en el mismo cable, así que los nodos de suma no requieren ninguna puerta de dos qubits. El número de recargas depende del grado del polinomio que se ajusta en la arista. Para este trabajo se usó grado 4 de forma fija.
- Multiplicación: se implementa con una puerta
IsingZZcombinada con unCNOT, el único punto del circuito que introduce entrelazamiento entre cables. - Lectura en un solo qubit: toda la información colapsa en un cable de salida, y la predicción es el valor esperado de Pauli-Z de ese qubit, pasado por una sigmoide para obtener una probabilidad de clase.
La etapa de capa oculta a salida es un lector variacional y no reproduce literalmente una segunda capa de KAN, porque el valor de un nodo oculto vive en la fase de un qubit y no puede volver a cargarse sin una medición intermedia. Por esta razón solo se soportan redes de profundidad 2. Se trata de una limitación de diseño explícita, motivada también por el riesgo de barren plateaus al apilar capas de re-uploading (Arias Alamo et al., 2025), y queda como trabajo futuro.
El modelo puede ejecutarse en tres simuladores, que representan puntos sucesivamente más realistas del mismo circuito: ideal (lightning.qubit, sin ruido ni muestreo finito), shots (default.qubit con número finito de disparos, que introduce el ruido estadístico de una medición real) y noisy (Qiskit Aer con un modelo de ruido derivado de FakeManilaV2, que además simula la decoherencia y el error de puerta de un dispositivo IBM concreto). FakeManilaV2 modela ibmq_manila, un dispositivo real de 5 qubits, mientras que el circuito de referencia usa 11, los primeros 5 son modelados con el ruido de FakeManilaV2 y el resto es modelado como ideal.
El entrenamiento usa entropía cruzada binaria con logits, el optimizador Adam y un scheduler ReduceLROnPlateau que reduce la tasa de aprendizaje a la mitad cuando la validación se estanca. La simulación es costosa: en promedio sobre las cinco semillas, el backend noisy toma unos 2,460 s por evaluación completa, frente a ~135 s en ideal, una diferencia de unas 18 veces. Por ello, cada época entrena sobre un subconjunto aleatorio fresco (~1,000 muestras) y valida sobre un subconjunto fijo.
6. Inicialización del circuito: el warm start
Antes de afinar el circuito con descenso de gradiente es necesario fijar los ángulos iniciales. Se compararon tres estrategias.
Chebyshev. Cada respuesta de arista aislada se ajusta como $y \approx \sum_{i=0}^{N} c_i T_i(x)$ sobre $[-1,1]$, siguiendo el diseño de la Chebyshev-KAN (Sidharth et al., 2024), y los coeficientes resultantes se convierten en los ángulos iniciales de rotación. El grado se fija en $N=4$ para todas las aristas. La elección de un grado fijo en lugar de uno adaptativo proviene de un error diagnosticado durante el proyecto. Originalmente se buscaba el grado más pequeño que superara un umbral de $R^2$, pero ese criterio casi siempre elegía grados bajos y producía métricas inconsistentes, porque el circuito perdía la información de la estructura clásica. El síntoma fue una caída abrupta del AUC de referencia (de ~0.80 a 0.26-0.36) cuando el conjunto de entrenamiento se reducía. El ajuste no está anidado por grado: reducir el grado elimina los coeficientes de orden alto y además perturba los de orden bajo que se conservan. Volver a un grado fijo restauró el comportamiento esperado, y el caso queda documentado como uno de los hallazgos del proyecto.
Base de seno. Como alternativa se implementó una base sinusoidal de frecuencia fija, siguiendo el diseño de SineKAN (Reinhardt et al., 2025): $y \approx \sum_k A_k \sin(\text{freq}_k \, x + \text{phase}_k)$, con las amplitudes $A_k$ obtenidas por mínimos cuadrados sobre una malla fija de frecuencias y fases. En SineKAN, la noción de «grado» de la arista corresponde exactamente al número de términos seno sumados en esa malla, es decir, a la cantidad de armónicos sinusoidales acumulados, en contraste con el polinomio de grado creciente de Chebyshev. Esta base es además la que usa Ria Khatoniar en la rama de lectura clásica de su proyecto de GSoC 2025 (Khatoniar, 2025a, sección 10), y el script de referencia empleado para portar fielmente la construcción de la malla de frecuencias y fases (constantes $A=0.9724$, $K=0.9884$, $C=0.9994$ del SineKANLayer original) proviene directamente de su código.
Con esta base fija se replicó el experimento de Chebyshev a pequeña escala, ajustando aristas reales extraídas del pipeline con ambas bases y comparando su $R^2$. El resultado confirma cuantitativamente lo que sugiere la teoría: sobre las 110 aristas extraídas en las cinco semillas, el ajuste de la base de seno es moderado, con un $R^2$ medio de aproximadamente 0.56 (mediana de 0.84), muy por debajo del ajuste casi perfecto de Chebyshev ($R^2$ medio de 0.998). Sin un término constante, la base de seno no puede representar desplazamientos estáticos (offsets) y produce $R^2$ negativo en algunas aristas.
Como verificación posterior de esta hipótesis, repetimos únicamente el ajuste por mínimos cuadrados (sin el pipeline completo de entrenamiento del circuito), añadiendo un término constante a la base de seno. El resultado confirma la causa: el $R^2$ del ajuste mejora y pasa a superar incluso al de Chebyshev. Esto descarta otros problemas del procedimiento de mínimos cuadrados, como un mal condicionamiento de la malla fija de frecuencias, y atribuye el ajuste débil de la base de seno original al término constante faltante. Dicho esto, esta verificación se quedó en el nivel del ajuste por arista: no volvimos a correr el circuito completo con esta base extendida, así que no sabemos si ese mejor $R^2$ se traduce en un mejor AUC inicial del warm start. Un ajuste más fiel de cada arista no garantiza automáticamente una mejor clasificación al otro lado del circuito, así que esta sigue siendo una pregunta abierta.
Este hallazgo es compatible con un artículo teórico reciente sobre la misma base: “Sinusoidal Approximation Theorem for KANs” (Gleyzer et al., 2025) da una prueba constructiva de aproximación universal para KANs con base sinusoidal, en la línea del KAT original. El teorema garantiza que, con suficientes términos y libertad para ajustar frecuencia y fase, una base de senos puede aproximar cualquier función continua. El resultado de este proyecto muestra que una malla fija, sin término constante y con solo $N=4$ armónicos, todavía no aprovecha esa capacidad.
Inicialización aleatoria. Como control, se conserva exactamente la topología podada (mismos qubits y conexiones) y cada ángulo se muestrea de $\mathcal{N}(0,1)$. Esto separa el valor del conocimiento clásico transferido del valor de la topología por sí sola.
Clamp en coseno: Tanto los coeficientes de Chebyshev como los ángulos de inicialización aleatorios se convierten en el ángulo de rotación de la compuerta $R_Z$ correspondiente pasando por un arccoseno, es decir, $\theta = \arccos(\text{valor})$, asegurando que los ángulos permanezcan dentro del rango válido para la rotación. Como arcocoseno está definido entre $[-1,1]$, cualquier valor fuera de este rango se recorta (clamp) a los límites entre [-0.9999, 0.9999]. La base seno tiene sus valores entre [-1,1], por lo que no se aplicó el clamp.
7. Línea base clásica: Random Forest
Para calibrar la distancia entre el enfoque cuántico y lo alcanzable clásicamente, se añadió un Random Forest de 300 árboles (profundidad máxima 35) con pesos de clase balanceados. A diferencia de la canalización KAN, recibe las 22 variables completas, sin poda. Usa las mismas claves de métricas que los entrenadores de la KAN, de modo que todos los modelos se agregan en una sola tabla de resultados.
8. Resultados
Todas las métricas por corrida se recolectan en una única tabla Parquet (65 filas a través de 5 semillas). Todos los experimentos usan el corte de masa y los cinco subconjuntos disjuntos: cada semilla (10-14) entrena y evalúa todos los modelos sobre su propio subconjunto, de modo que las cinco semillas funcionan como réplicas.
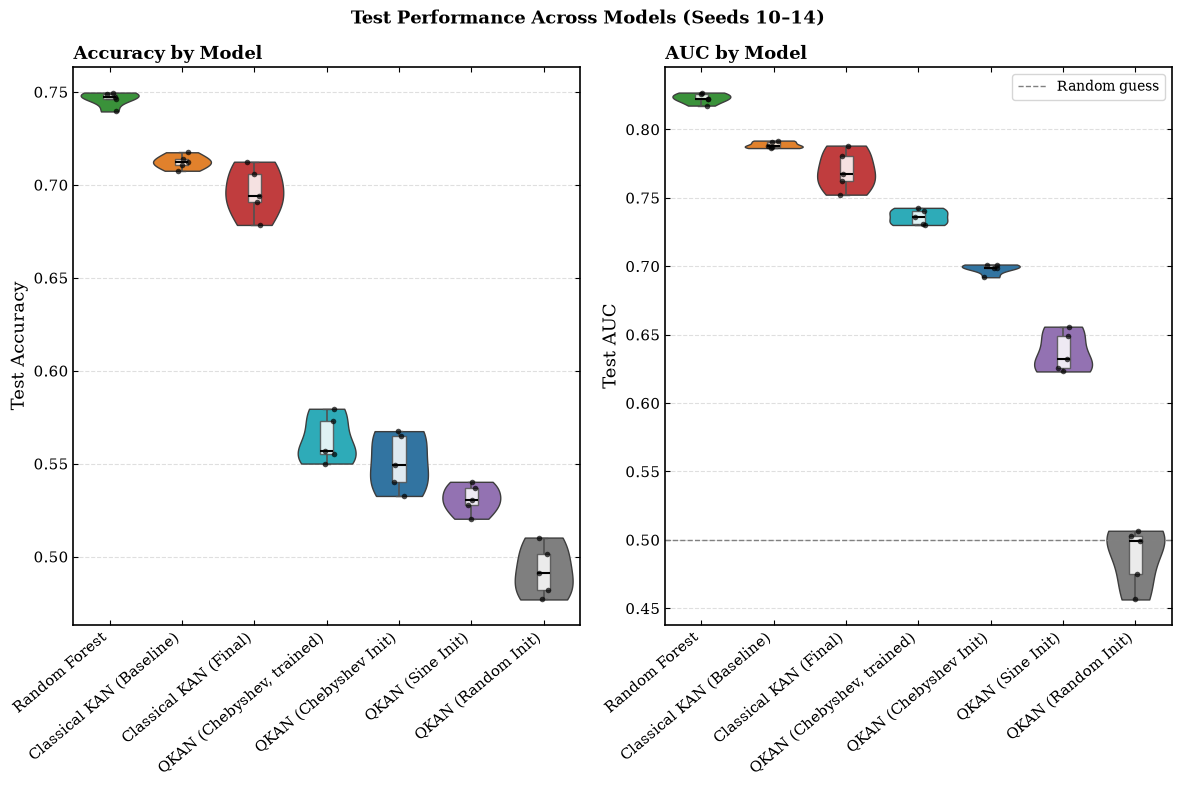
La siguiente figura muestra la distribución por semilla de la exactitud y el AUC de prueba para siete modelos representativos de la cadena, desde el Random Forest hasta la QKAN inicializada al azar sin entrenar. La tabla resume la media ($\pm$ desviación estándar sobre 5 semillas) de todos los modelos.
| Modelo | AUC (media $\pm$ σ) | Exactitud (media $\pm$ σ) | Rechazo de fondo en $\varepsilon_S=0.5$ |
|---|---|---|---|
| Random Forest (22 features) | 0.823 $\pm$ 0.004 | 0.746 $\pm$ 0.004 | 10.04 $\pm$ 0.57 |
| KAN clásica, base | 0.789 $\pm$ 0.002 | 0.712 $\pm$ 0.004 | 7.20 $\pm$ 0.37 |
| KAN, reentrenada tras la poda | 0.756 $\pm$ 0.004 | 0.687 $\pm$ 0.005 | 5.81 $\pm$ 0.29 |
| KAN, simbólica | 0.756 $\pm$ 0.004 | 0.687 $\pm$ 0.005 | 5.79 $\pm$ 0.29 |
| KAN final (simbólica + fine-tune) | 0.770 $\pm$ 0.014 | 0.696 $\pm$ 0.013 | 6.35 $\pm$ 0.75 |
| QKAN, entrenada (ideal) | 0.736 $\pm$ 0.006 | 0.563 $\pm$ 0.013 | 5.46 $\pm$ 0.14 |
| QKAN, entrenada (shots) | 0.732 $\pm$ 0.006 | 0.571 $\pm$ 0.015 | 5.42 $\pm$ 0.13 |
| QKAN, entrenada (noisy) | 0.730 $\pm$ 0.006 | 0.571 $\pm$ 0.016 | 5.40 $\pm$ 0.13 |
| QKAN warm start, Chebyshev | 0.698 $\pm$ 0.004 | 0.551 $\pm$ 0.015 | 4.37 $\pm$ 0.23 |
| QKAN warm start, Seno | 0.637 $\pm$ 0.015 | 0.531 $\pm$ 0.008 | 3.26 $\pm$ 0.15 |
| QKAN warm start, aleatorio | 0.488 $\pm$ 0.021 | 0.492 $\pm$ 0.014 | 1.81 $\pm$ 0.21 |
De esta tabla se desprenden tres observaciones. Primero, la poda cuesta ~0.03 de AUC respecto a la KAN base (de 0.789 a 0.756), el ajuste simbólico conserva ese valor y el fine-tune final recupera una parte (0.770). La QKAN entrenada queda 0.02 adicional por debajo de la KAN reentrenada, que ya trabaja con las mismas dos variables: el circuito alcanza AUC ~0.73-0.74 usando solo dos variables y 10 u 11 qubits. Segundo, el afinado tiene un efecto medible: entrenar el circuito eleva el warm start de Chebyshev de 0.698 a 0.736 en el simulador ideal. Tercero, los tres backends (ideal, disparos finitos y ruidoso) difieren entre sí en no más de ~0.006 de AUC; dentro del modelo de ruido utilizado, el circuito no se degrada visiblemente.
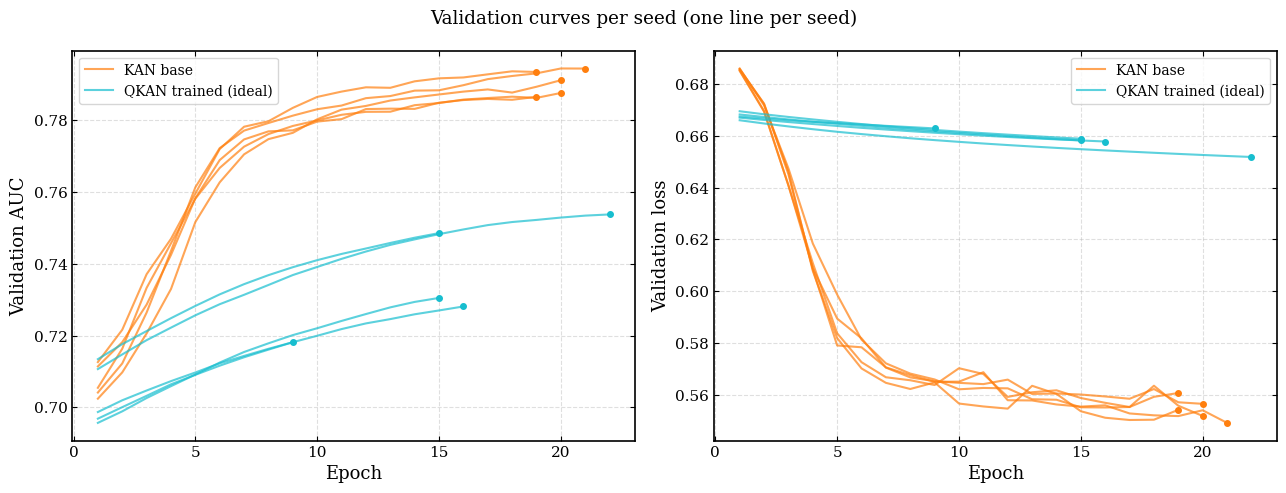
Las curvas de validación por semilla muestran por qué el efecto del afinado todavía es modesto. La KAN clásica base converge en unas 20 épocas y su AUC de validación se estabiliza antes de la detención temprana. La QKAN se comporta de otra forma: su AUC de validación crece casi linealmente, unos 0.003 por época, y sigue subiendo cuando el entrenamiento se detiene, entre las épocas 9 y 22 de un máximo de 50. Cada época usa 1,000 muestras con un tamaño de lote de 1,024, es decir, un solo paso de optimización, y el criterio de detención exige una mejora mayor a $5\times10^{-3}$, más de lo que gana un paso. La QKAN queda, por tanto, subentrenada, y sus métricas deben leerse como una cota inferior de lo que el circuito puede alcanzar. La pérdida de validación apenas se mueve (ronda 0.66, cerca de $\ln 2 \approx 0.693$) mientras el AUC crece: con el logit acotado a $[-1, 1]$, ni un clasificador perfecto podría bajar la entropía cruzada de $\ln(1+e^{-1}) \approx 0.31$, así que la pérdida es una señal débil del progreso, mientras que el ordenamiento de los eventos sí mejora.
La comparación entre bases de warm start confirma el orden Chebyshev > Seno > Aleatorio, tanto en AUC como en rechazo de fondo. La figura siguiente muestra la curva completa de rechazo de fondo ($1/\varepsilon_B$) frente a eficiencia de señal para los mismos siete modelos. El orden Chebyshev > Seno > Aleatorio se mantiene a lo largo de toda la curva, y la QKAN entrenada queda por encima de su warm start de Chebyshev y por debajo de las KAN clásicas.
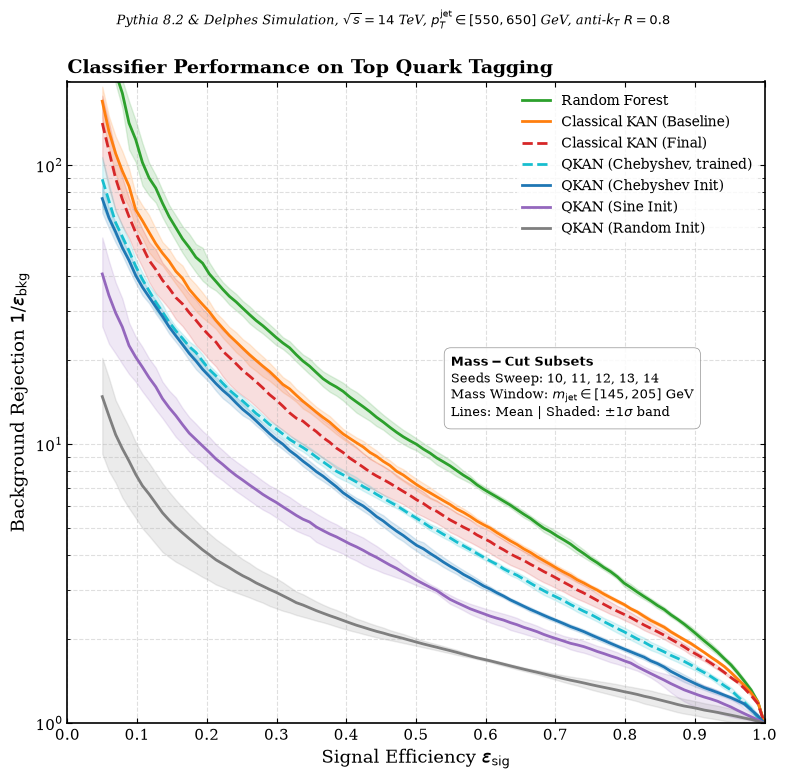
En estas curvas, inicializar el circuito con la base de Chebyshev, sin entrenamiento adicional, rechaza aproximadamente 2.4 veces más fondo que la inicialización aleatoria en el punto de trabajo de eficiencia de señal del 50% ($\varepsilon_S=0.5$) (4.37 frente a 1.81), y la base de seno queda en un punto intermedio (3.26), consistente con su ajuste de arista más débil. La brecha aumenta en el punto de trabajo más exigente, $\varepsilon_S=0.3$, donde Chebyshev rechaza cerca de 3.6 veces más fondo que el control aleatorio (10.4 frente a 2.9). En $\varepsilon_S=0.9$ la brecha se cierra (1.4 frente a 1.1): es el régimen de máxima eficiencia de señal, donde cualquier clasificador, incluido el aleatorio, deja pasar casi todo el fondo.
Para verificar que estas diferencias superan el ruido estadístico de solo cinco semillas, se realizaron pruebas $t$ pareadas ($\alpha=0.05$), con hipótesis nula de que la inicialización aleatoria y cada warm start dan la misma exactitud y AUC:
| Comparación | Exactitud | AUC |
|---|---|---|
| Aleatorio vs Chebyshev | $t=-4.86$, $p=0.0082$ | $t=-20.17$, $p=3.6\times10^{-5}$ |
| Aleatorio vs Seno | $t=-5.00$, $p=0.0075$ | $t=-17.95$, $p=5.7\times10^{-5}$ |
Ambas hipótesis nulas se rechazan con claridad, aunque el resultado debe leerse con cautela porque descansa en solo cinco semillas.
En promedio sobre las cinco semillas, la exactitud del circuito cuántico ronda 0.56-0.57, frente a ~0.70 de la KAN clásica, con recall ~0.97 y precisión ~0.54 (0.98 y 0.53 en la corrida de referencia). La señal de ordenamiento, medida por AUC, se conserva, pero el umbral fijo en 0.5 está mal calibrado para la salida del circuito.
La figura siguiente muestra las matrices de confusión normalizadas por clase verdadera (cada fila suma 1), con la media y la desviación estándar sobre las cinco semillas. Cada semilla tiene el mismo número de jets de señal y de fondo en su conjunto de prueba (4,733 de cada clase), así que las tasas de las distintas semillas son directamente comparables.
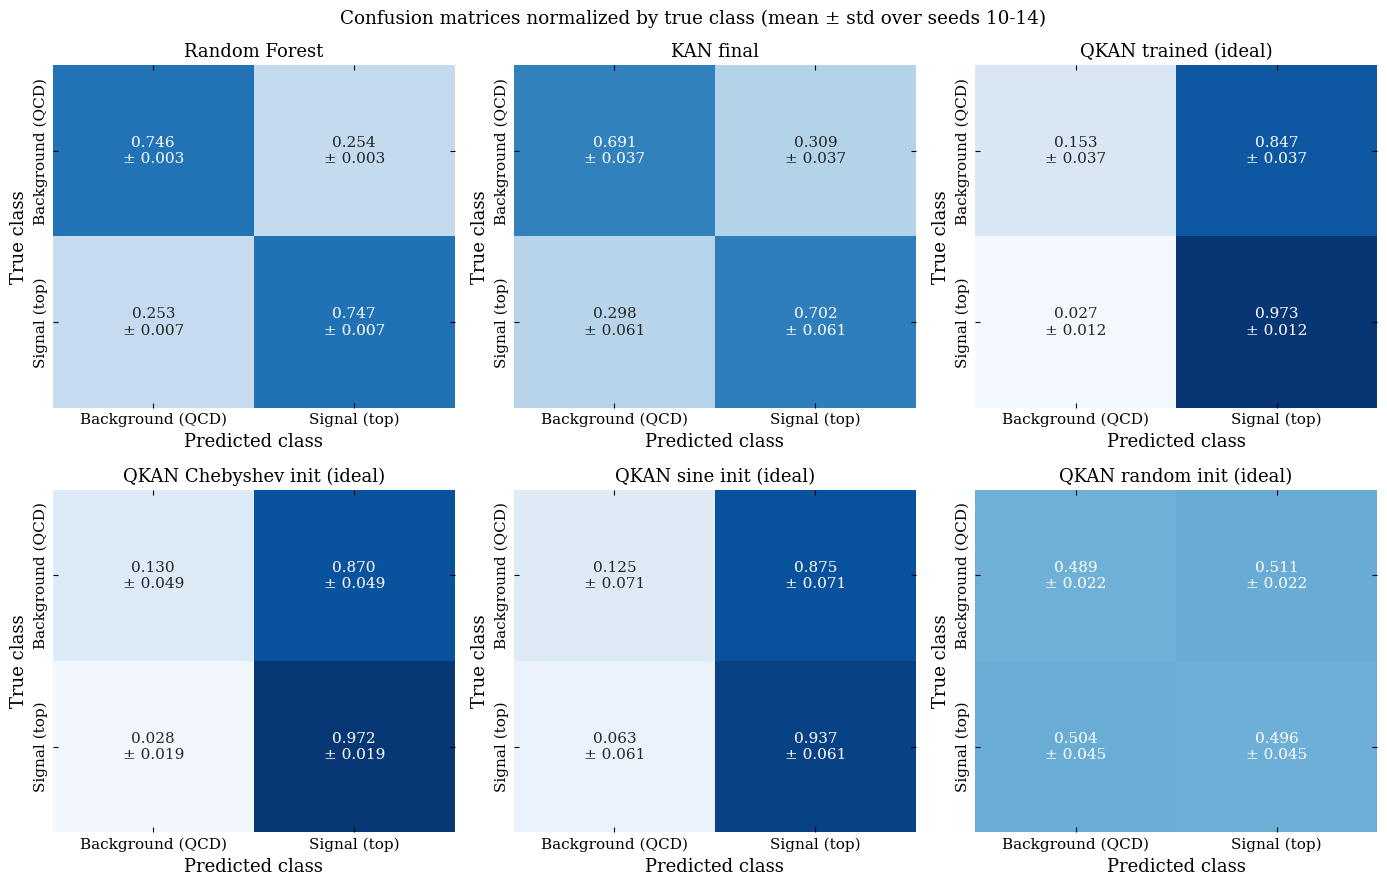
El Random Forest y la KAN final tienen matrices casi simétricas (~0.75 en la diagonal para el Random Forest y ~0.69-0.70 para la KAN final), de modo que sus errores se reparten entre las dos clases y su exactitud concuerda con su AUC. La QKAN, tanto con las inicializaciones de Chebyshev y seno como después del entrenamiento, clasifica correctamente más del 97% de los jets de top, pero solo entre el 13% y el 15% de los jets de QCD. Como la salida $\langle Z \rangle \in [-1,1]$ se usa como logit, las probabilidades quedan en la práctica dentro de ~[0.48, 0.72], y casi todos los eventos caen por encima del umbral de 0.5. El entrenamiento mejora apenas la tasa de verdaderos negativos (de 0.130 a 0.153): reordena los eventos, lo que eleva el AUC, sin moverlos a través del umbral. La inicialización aleatoria queda cerca de 0.5 en las cuatro celdas, el comportamiento de un clasificador al azar. Por esta razón se reporta el AUC como métrica principal en lugar de la exactitud.
9. Comparación con la literatura
El artículo de referencia de este benchmark, Kasieczka et al. (2019), y el notebook comparativo más citado que reproduce y extiende sus cifras, SebastianMacaluso/TopTagComparison, reúnen 12 taggers clásicos y de aprendizaje profundo (ParticleNet, TreeNiN, ResNeXt, PFN, CNN, NSub, LBN, P-CNN, LoLa, EFN, EFP, TopoDNN) más el meta-tagger GoaT, evaluados sobre el dataset completo de 2 millones de jets, sin restricción de masa. En la tabla original (“single model”), el AUC va de 0.955 (LDA, el tagger más débil, excluido explícitamente del meta-tagger por no aportar señal) a 0.985 (ParticleNet); excluyendo LDA, el rango es de 0.972 (TopoDNN) a 0.985 (ParticleNet). El rechazo de fondo a $\varepsilon_S=0.3$ va, en la misma tabla, de 295 ± 14 (LDA) a 1412 ± 46 (ParticleNet).
Esta comparación requiere una advertencia explícita: esos números usan el dataset completo, sin cortes, mientras que todos los resultados de este proyecto corresponden al régimen con corte de masa agresivo (145-205 GeV), diseñado para remover la pista más fácil y forzar a los modelos a usar subestructura. Por tanto, las cifras no son comparables punto por punto: el AUC de 0.823 del Random Forest o de 0.736 de la QKAN entrenada se obtiene sobre un problema deliberadamente más difícil que el de la tabla de referencia. Una comparación directa requiere evaluar la misma canalización sin corte de masa y con réplicas, lo que queda como trabajo futuro.
Además del corte de masa, dos factores amplían esta brecha. El primero es la compresión de variables: la poda reduce 22 variables a solo 2, mientras que arquitecturas como ParticleNet o IAFormer consumen la nube completa de constituyentes con grafos o atención dispersa diseñados para esa alta dimensión. El segundo, identificado al revisar el preprocesamiento después de obtener los resultados principales, es que cada jet trae hasta 200 constituyentes y la canalización solo usa los 10 más energéticos. Esta simplificación deliberada mantiene el circuito simulable, pero deja fuera casi toda la subestructura de baja energía, precisamente donde arquitecturas como IAFormer (Esmail et al., 2026) o L-GATr (Brehmer et al., 2025), equivariante de Lorentz, reportan ganancias. Junto con el corte de masa y la compresión a dos variables, constituye un tercer motivo de la brecha frente al estado del arte.
10. Trabajo relacionado: otros enfoques de KAN cuántica
Existen otros esfuerzos para combinar KANs con computación cuántica. A continuación se sitúa este proyecto frente a tres de ellos, cada uno de los cuales aborda el mismo cuello de botella (cómo cuantizar una función univariada aprendible) con una estrategia distinta.
QKAN (Ivashkov et al., 2024) es la propuesta teórica que motivó desde el inicio la búsqueda de una alternativa ejecutable en hardware ruidoso. Implementa las funciones univariadas de una KAN mediante codificación de bloque (block encoding) y Transformación de Valores Singulares Cuántica (QSVT). Esto le da garantías de expresividad sólidas, pero la ata a primitivas tolerantes a fallos que ningún dispositivo NISQ actual puede ejecutar de forma nativa. Representa el techo teórico frente al que se mide cualquier QKAN diseñada para el hardware actual: ofrece mayores garantías, pero hoy no es ejecutable.
El proyecto QKAN de Ria Khatoniar (Khatoniar, 2025a, 2025b; GSoC 2025, también en ML4SCI) es el antecedente más cercano en el tiempo y el que inspiró directamente la elección de la base de seno en este trabajo. Su primer informe describe un QKAN híbrido que combina codificación QSVT, combinación lineal de unitarios cuántica (LCU) y una prueba de Hadamard para la suma, con lectura clásica tipo KAN/SineKAN; reporta explícitamente que la arquitectura no pudo escalar más allá de cierto punto en el dataset de quark-gluon, por fallos de memoria (kernel crashes) del simulador. Su segundo informe presenta una KAN completamente cuántica basada en una Quantum Circuit Born Machine (QCBM), con qubits de etiqueta y de posición, una capa de entrelazamiento (LabelMixer) y lectura vía Pauli-Z/X; ahí declara que extender el enfoque a quark-gluon o a predicción de masa de jet “todavía no pudo lograrse, principalmente porque la arquitectura actual es computacionalmente lenta”, y se limita a simuladores. Ambos informes concluyen señalando la intención de continuar a futuro. Este proyecto retoma esa dirección con la elección de la base sinusoidal para el warm start, usando como referencia directa el código de SineKANLayer de su repositorio.
QuKAN (Werner et al., 2025) explora un enfoque distinto al de Ivashkov et al. pese a la similitud del nombre: en lugar de codificar cada función univariada mediante QSVT, usa directamente una Quantum Circuit Born Machine como mecanismo generativo para representarlas, cuántico desde el principio y sin destilar una KAN clásica ya entrenada.
En conjunto, los cuatro proyectos (Ivashkov et al., Khatoniar, Werner et al. y este trabajo) muestran un patrón claro: escalar una KAN cuántica más allá de un puñado de variables es, en 2025-2026, un problema abierto compartido. Las causas son la dependencia de primitivas tolerantes a fallos (Ivashkov et al.), la memoria de simulación (Khatoniar), el costo de un mecanismo generativo cuántico (Werner et al.) o, en este caso, la necesidad de podar agresivamente antes de poder simular el circuito. Ninguno de los cuatro ha demostrado todavía una QKAN ejecutándose sin compromisos sobre un dataset de HEP a escala completa.
11. Conclusiones
Cinco conclusiones resumen el proyecto.
- La poda clásica funciona como filtro de qubits. La KAN reduce 22 entradas a dos variables (masa y multiplicidad) y 10 u 11 qubits según la semilla, y el circuito todavía alcanza un AUC de ~0.73 con corte de masa.
- El warm start transporta información real. El orden Chebyshev > Seno > Aleatorio es consistente entre semillas y estadísticamente significativo sobre cinco réplicas. La inicialización aleatoria rinde a nivel de azar (AUC ~0.49), lo que muestra que la topología por sí sola no basta. La base de Chebyshev es superior porque su ajuste por arista está mucho más cerca de la respuesta clásica real ($R^2$ medio de 0.998, frente a ~0.56 para la base de seno).
- El ruido simulado tiene un efecto pequeño. La brecha entre los backends
idealynoisyes a lo sumo de ~0.006 de AUC. El resultado es alentador, pero proviene de un modelo de ruido simulado y aún debe validarse en hardware real. Además, el costo de simularlo es considerable: evaluar el backendnoisytoma en promedio ~18 veces más tiempo que elideal. - El corte de masa define un problema deliberadamente difícil. Remover la pista simple de la masa obliga a los modelos a apoyarse en subestructura, que las dos variables sobrevivientes solo capturan parcialmente. Por eso las cifras del proyecto no son comparables punto por punto con las de la literatura, obtenidas sin corte.
- El techo clásico lo marca el Random Forest. Tiene acceso a las 22 variables y lidera en todas las métricas; el modelo cuántico no lo supera. El valor del enfoque híbrido reside en producir un circuito compacto e interpretable que preserva una fracción considerable de ese desempeño.
12. Contribuciones
- Una canalización reproducible y consciente del régimen de datos: los distintos regímenes están codificados en la organización de directorios, los subconjuntos de réplicas están balanceados por clase, cada etapa es idempotente vía checkpoints, y los resultados de varias semillas se recolectan en una sola tabla Parquet.
HEPKAN, una subclase depykanque corrige un error de serialización en la poda de entradas y reduce la sobrecarga de graficado y registro.- Una regla de poda diseñada específicamente para los límites cuánticos, que combina umbrales de atribución con un tope duro de fan-in.
- Un puente clásico-cuántico: el extractor convierte una KAN podada en un grafo de suma/multiplicación, y el constructor de la QKAN convierte ese grafo en un circuito de PennyLane.
- Dos bases intercambiables más un control, que permiten medir el valor del warm start en tres backends de simulación, evaluados antes y después del entrenamiento.
- Una falla diagnosticada y corregida: la búsqueda adaptativa de grado de Chebyshev colapsaba silenciosamente el AUC de referencia en conjuntos de datos más pequeños; se identificó la causa y se reemplazó por un grado fijo.
- Un benchmark clásico, el Random Forest, evaluado con las mismas métricas y la misma partición de datos.
- Un análisis exploratorio que documenta la disposición del dataset, el artefacto de $\Delta R$ y la elección de 10 constituyentes y 22 entradas.
13. Limitaciones y trabajo futuro
- Pocas réplicas: las pruebas estadísticas usan cinco semillas, y cada semilla usa su propio subconjunto, por lo que el efecto de la semilla y el del subconjunto no se pueden separar.
- Solo el régimen con corte de masa: falta evaluar la canalización sin corte de masa y con réplicas, lo que permitiría una comparación directa con la literatura.
- Compresión extrema: la poda deja ~2 variables de entrada; relajarla eleva el número de qubits más allá de lo simulable en tiempo razonable.
- Solo los 10 constituyentes más energéticos de hasta 200 por jet: una restricción adicional que probablemente descarta subestructura de baja energía relevante.
- Subentrenamiento: cada época de la QKAN es un solo paso de optimización y el umbral de detención temprana es grueso, así que el entrenamiento se detiene mientras el AUC de validación todavía mejora.
- Calibración: la exactitud y la precisión cuánticas son débiles incluso donde el AUC es bueno; queda pendiente estudiar un umbral de decisión afinado.
- Base de seno: añadir un término constante al ajuste por mínimos cuadrados eleva su $R^2$ por encima del de Chebyshev, confirmando que la falta de ese término era la causa del $R^2$ débil original. Pero esa verificación se quedó en el nivel del ajuste por arista: falta correr el circuito completo con la base extendida para saber si ese mejor ajuste efectivamente se traduce en un AUC de warm start más alto que el de Chebyshev, o si se pierde algo en la codificación a ángulos de rotación.
- Solo ruido simulado y parcial:
FakeManilaV2aproxima un dispositivo real, pero no lo es; y como ese dispositivo tiene 5 qubits frente a los 11 del circuito, el ruido calibrado solo cubre los primeros 5, el resto del circuito corre ideal incluso en el backend noisy. Extender el modelo de ruido a los 11 qubits, o repetir el experimento con un dispositivo de referencia de tamaño comparable, es un paso obvio antes de sacar conclusiones firmes sobre tolerancia al ruido considerando un incremento bastante grande de tiempo que conllevaría este enfoque completamente ruidoso y simulado, lo cual queda pendiente. - Solo redes de profundidad 2: KANs más profundas requerirían medición intermedia y recodificación. Apilar más capas de re-uploading sin ese rediseño es técnicamente difícil y aumenta el riesgo de barren plateaus, por lo que esta dirección depende de resolver primero la medición intermedia.
- Otros datasets: existe una canalización de preprocesamiento para etiquetado de quark-gluon.
En suma, el proyecto muestra que una KAN clásica puede decidir la forma de un circuito cuántico, que el conocimiento transferido a través de una buena base tiene un efecto medible, y que el modelo compacto resultante preserva una parte útil de la señal de clasificación. El modelo todavía no iguala la mejor línea base clásica, y ese límite se reporta junto con los resultados.
Agradecimientos
Quiero agradecer a mi amigo Eduardo Villamil por proporcionarme recursos computacionales para este proyecto, a ML4SCI por la oportunidad de participar en Google Summer of Code 2026, y a todos los administradores, mentores y miembros del programa por su retroalimentación útil a lo largo del proyecto.
Referencias
- Arias Alamo, D., Hernández López, S., & Lázaro González, J. (2025). Is data-reuploading really a cheat code? An experimental analysis. In Proceedings of the 1st International Conference on Quantum Software (IQSOFT 2025). https://doi.org/10.5220/0013555000004525
- Brehmer, J., Bresó, V., de Haan, P., Plehn, T., Qu, H., Spinner, J., & Thaler, J. (2025). A Lorentz-equivariant transformer for all of the LHC. SciPost Physics. https://arxiv.org/abs/2411.00446
- Esmail, W., Hammad, A., & Nojiri, M. (2026). IAFormer: Interaction-aware transformer network for collider data analysis. SciPost Physics, 20, Article 108. https://arxiv.org/abs/2505.03258
- Gleyzer, S., Nguyen, H., Ramakrishnan, D. P., & Reinhardt, E. A. F. (2025). Sinusoidal approximation theorem for Kolmogorov–Arnold networks. Mathematics, 13(19), Article 3157. https://doi.org/10.3390/math13193157
- Ivashkov, P., Huang, P.-W., Koor, K., Pira, L., & Rebentrost, P. (2024). QKAN: Quantum Kolmogorov-Arnold networks with applications in machine learning and multivariate state preparation. arXiv. https://arxiv.org/abs/2410.04435. Publicado en 2026 en npj Quantum Information. https://doi.org/10.1038/s41534-026-01202-5
- Kasieczka, G., Plehn, T., Thompson, J., & Russell, M. (2019). Top quark tagging reference dataset (Version v0) [Data set]. Zenodo. https://doi.org/10.5281/zenodo.2603256. Ver también el artículo asociado: Kasieczka, G., et al. (2019). The Machine Learning landscape of top taggers. SciPost Physics, 7, 014. https://arxiv.org/abs/1902.09914
- Khatoniar, R. (2025a). GSoC 2025 | Quantum Kolmogorov-Arnold networks for high energy physics analysis at the LHC (parte I) [Entrada de blog]. Medium. https://medium.com/@riakhatoniar1234/gsoc-2025-quantum-kolmogorov-arnold-networks-for-high-energy-physics-analysis-at-the-lhc-a98207bf6d4c
- Khatoniar, R. (2025b). GSoC 2025 | Quantum Kolmogorov-Arnold networks for high energy physics analysis at the LHC (parte II) [Entrada de blog]. Medium. https://medium.com/@riakhatoniar1234/gsoc-2025-quantum-kolmogorov-arnold-networks-for-high-energy-physics-analysis-at-the-lhc-part-8b44f5616e6f
- Liu, Z., Wang, Y., Vaidya, S., Ruehle, F., Halverson, J., Soljačić, M., Hou, T. Y., & Tegmark, M. (2024). KAN: Kolmogorov-Arnold networks. arXiv. https://arxiv.org/abs/2404.19756
- Liu, Z., Ma, P., Wang, Y., Matusik, W., & Tegmark, M. (2024). KAN 2.0: Kolmogorov-Arnold networks meet science. arXiv. https://arxiv.org/abs/2408.10205
- Macaluso, S. (n.d.). TopTagComparison [Repositorio de código]. GitHub. Recuperado el 21 de septiembre de 2026, de https://github.com/SebastianMacaluso/TopTagComparison
- Reinhardt E, Ramakrishnan D and Gleyzer S (2025) SineKAN: Kolmogorov-Arnold Networks using sinusoidal activation functions. Front. Artif. Intell. 7:1462952. doi: 10.3389/frai.2024.1462952
- Sidharth, S. S., Gokul, R., Anas, K. P., & Keerthana, A. R. (2024). Chebyshev polynomial-based Kolmogorov-Arnold networks: An efficient architecture for nonlinear function approximation. arXiv. https://arxiv.org/abs/2405.07200
- Werner, Y., Malemath, A., Liu, M., Fortes Rey, V., Palaiodimopoulos, N., Lukowicz, P., & Kiefer-Emmanouilidis, M. (2025). QuKAN: A quantum circuit Born machine approach to quantum Kolmogorov Arnold networks. Scientific Reports, 15. https://doi.org/10.1038/s41598-025-22705-9
Dataset: Zenodo record 2603256 (top tagging, Pythia8 + Delphes ATLAS). Este proyecto parte de la propuesta original enviada a GSoC 2026 / ML4SCI, “Quantum Sine-Kolmogorov-Arnold Networks for High Energy Physics Analysis” (Toral, J., 2026).